Data Engineer aannemen voor big data projecten: deze hiring mistakes wil je voorkomen
17 september 2026
Data Engineer aannemen voor big data projecten: deze hiring mistakes wil je voorkomen
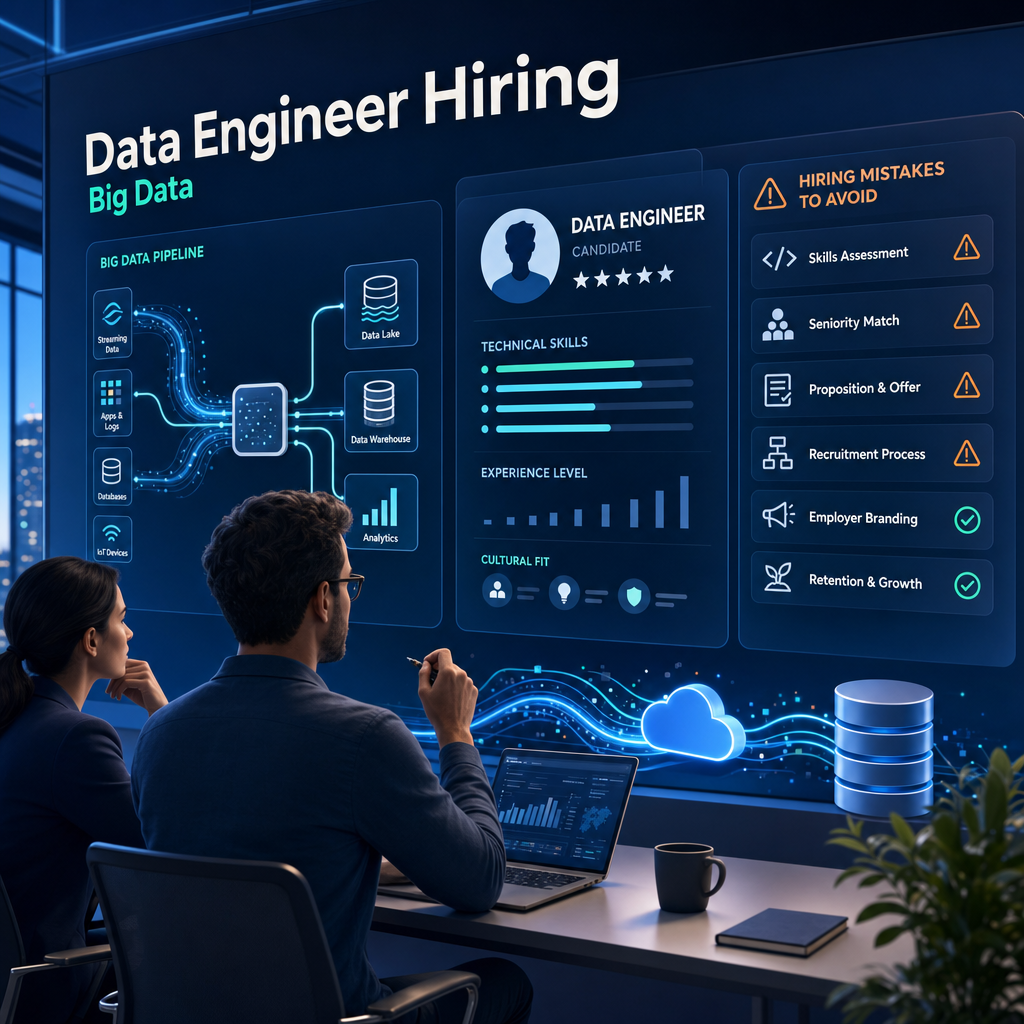
Welke fouten maken bedrijven bij het aannemen van een Data Engineer voor big data projecten? Vaak begint het probleem al vóór de eerste kandidaat spreekt. Het functieprofiel is te breed, de technische toets te oppervlakkig of het salaris sluit niet aan op de gewenste senioriteit. Juist bij big data projecten betaal je die fouten snel terug in trage pipelines, slechte datakwaliteit en afhankelijke teams.
Samenvatting
De kern: huur niet alleen op tooling, maar op schaalbare data-infrastructuur
- Kijk verder dan losse tools zoals AWS, Azure, Docker of CI/CD. Een goede Data Engineer begrijpt architectuur, betrouwbaarheid en schaalbaarheid.
- Bepaal vooraf welk probleem de Data Engineer moet oplossen: data pipelines bouwen, performance verbeteren, cloudmigratie begeleiden of datakwaliteit borgen.
- Toets senioriteit op eigenaarschap, technische keuzes en impact op andere teams, niet alleen op jaren ervaring.
- Stem salaris, autonomie en technische uitdaging af op de schaarste binnen de data engineering arbeidsmarkt.
De grootste risico’s zitten in skills, salaris, recruitmentproces en retentie
De grootste hiring mistakes ontstaan wanneer recruitment losstaat van de technische realiteit. Een Data Engineer aannemen vraagt om scherpe keuzes in profiel, proces en propositie. Zonder die scherpte trek je kandidaten aan die niet passen, of verlies je sterke kandidaten voordat je een aanbod doet.
Wat doet een Data Engineer binnen een big data project?
Een Data Engineer bouwt de basis waarop data teams kunnen schalen
Een Data Engineer ontwerpt, bouwt en onderhoudt de data-infrastructuur waarop analytics, reporting, AI en data science draaien. Denk aan pipelines, datamodellen, opslag, verwerking, monitoring en toegangsstructuren. Zonder sterke data engineering blijft een big data project vaak steken in losse scripts en handmatig herstelwerk.
Voor schaalbare data infrastructuren telt vooral betrouwbaarheid. Data moet op het juiste moment, in de juiste vorm en met voldoende kwaliteit beschikbaar zijn. Dat vraagt om technische keuzes die passen bij volume, snelheid, security en toekomstige groei.
Het verschil tussen data verplaatsen en data betrouwbaar beschikbaar maken
Data verplaatsen is niet hetzelfde als data engineering. Een pipeline die vandaag draait, kan morgen falen door veranderende databronnen, slechte logging of ontbrekende tests. Een goede Data Engineer bouwt daarom niet alleen flows, maar denkt na over foutafhandeling, performance, governance en onderhoudbaarheid.
Juist daar gaat het vaak mis. Bedrijven zoeken iemand die “met data kan werken”, terwijl ze eigenlijk iemand nodig hebben die een robuust fundament neerzet voor meerdere teams. Dat verschil bepaalt of jouw dataomgeving schaalbaar blijft.
Welke hiring mistake ontstaat door te veel focus op losse tools?
Toolkennis zegt weinig zonder begrip van data-architectuur
De grootste fout is aannemen op een checklist met tools zonder te toetsen hoe iemand technische keuzes maakt. Ervaring met Python, Spark, SQL of cloud tooling klinkt relevant, maar zegt weinig als de kandidaat geen ontwerpkeuzes kan onderbouwen. Toolkennis krijgt pas waarde binnen de juiste architectuur.
Vraag daarom niet alleen of iemand een tool kent. Vraag waarom iemand voor een bepaalde oplossing kiest, welke trade-offs daarbij horen en hoe de oplossing schaalbaar blijft. Dat geeft veel sneller inzicht in echte Data Engineer skills.
Waarom ervaring met AWS, Azure, Docker of CI/CD context nodig heeft
AWS, Azure, Docker en CI/CD zijn relevant, maar de context bepaalt de waarde. Iemand kan pipelines deployen via CI/CD, maar alsnog moeite hebben met monitoring, incidentanalyse of kostenbewuste cloudarchitectuur. Voor big data projecten wil je weten hoe iemand tooling inzet binnen productieomgevingen.
Een sterke kandidaat kan uitleggen hoe dataflows draaien, hoe fouten zichtbaar worden en hoe teams veilig wijzigingen doorvoeren. Dat niveau van gesprek zegt meer dan een cv vol bekende namen. Veel bedrijven onderschatten dit.
Hoe je skills toetst op schaalbaarheid in plaats van alleen op stackmatch
Toets schaalbaarheid met realistische scenario’s. Leg bijvoorbeeld een situatie voor waarin datavolume groeit, pipelines trager worden of downstream teams andere datakwaliteit nodig hebben. Vraag welke stappen de kandidaat neemt en welke risico’s prioriteit krijgen.
Een goede toets gaat over denken, niet over trucjes. Laat ruimte voor keuzes rond batch versus streaming, opslag, observability, security en onderhoud. Zo herken je of iemand jouw dataomgeving verder brengt.
Waarom gaat het vaak mis bij het inschatten van senioriteit?
Een medior Data Engineer lost andere problemen op dan een senior profiel
Het gaat mis wanneer bedrijven medior en senior profielen op één hoop gooien. Een medior Data Engineer kan vaak prima pipelines bouwen binnen bestaande kaders. Een senior Data Engineer bepaalt juist kaders, bewaakt kwaliteit en maakt keuzes die meerdere teams raken.
Als jouw big data project architectuurkeuzes, cloudstrategie of teamoverstijgende afhankelijkheden bevat, zoek je waarschijnlijk senioriteit. Als de basis al staat en het werk vooral uitvoering vraagt, kan een medior profiel logisch zijn. Die afweging voorkomt overvragen én onderhuren.
Big data projecten vragen eigenaarschap over pipelines, kwaliteit en performance
Senioriteit blijkt vooral uit eigenaarschap. Een senior Data Engineer kijkt naar de volledige keten: brondata, transformatie, opslag, datakwaliteit, performance en gebruik door andere teams. Die persoon ziet sneller waar technische schuld ontstaat.
Vraag tijdens recruitment naar situaties waarin de kandidaat verantwoordelijkheid droeg voor falende pipelines of performanceproblemen. Niet om iemand af te rekenen, maar om te begrijpen hoe iemand analyseert, prioriteert en communiceert. Dat zegt veel over volwassenheid.
Wanneer je een specialist nodig hebt en wanneer een generalist voldoende is
Een specialist past wanneer jouw uitdaging diep technisch is, zoals streaming, cloud-native data platformen, performance tuning of complexe datamodellering. Een generalist past beter bij kleinere teams waar iemand breed moet schakelen tussen pipelines, dashboards, stakeholders en platformwerk.
Maak die keuze vóór je gaat sourcen. Een profiel dat tegelijk cloud architect, BI-specialist, Data Engineer en platform engineer moet zijn, schrikt goede kandidaten af. Het voelt niet ambitieus, maar ongericht.
Hoe voorkom je dat salaris en propositie goede Data Engineers afschrikken?
Schaarste zorgt voor salarisdruk, vooral bij ervaren data engineers
Schaarste aan ervaren Data Engineers zorgt voor salarisdruk. Vooral kandidaten die productieomgevingen kennen, cloudervaring hebben en zelfstandig architectuurkeuzes maken, vergelijken aanbiedingen scherp. Een salaris dat niet past bij de gevraagde senioriteit vertraagt je hiring direct.
Wees daarom eerlijk over het niveau dat je zoekt. Als je senior eigenaarschap vraagt, moet jouw salarisrange daarbij passen. Anders trek je vooral kandidaten aan die de complexiteit nog niet zelfstandig kunnen dragen.
Remote concurrentie maakt jouw aanbod direct vergelijkbaar
Remote werken maakt jouw aanbod vergelijkbaar met werkgevers buiten jouw regio. Data Engineers kijken niet alleen naar reistijd, maar ook naar flexibiliteit, technische inhoud en de volwassenheid van het team. Een hybride of remote beleid zonder duidelijke afspraken roept snel vragen op.
Maak concreet wat je biedt. Denk aan remote mogelijkheden, technische autonomie, cloudbudget, tooling, opleidingsruimte en de invloed op architectuur. Vage beloftes verliezen het snel van duidelijke proposities.
Waarom inhoud, autonomie en teamniveau net zo belangrijk zijn als salaris
Salaris opent het gesprek, maar inhoud bepaalt vaak of iemand blijft luisteren. Goede Data Engineers willen weten aan welk platform ze bouwen, welke datasets belangrijk zijn en hoeveel invloed ze krijgen op technische keuzes. Autonomie telt zwaar bij ervaren profielen.
Laat daarom zien met wie iemand werkt. Een sterk engineering team, heldere ownership en serieuze aandacht voor datakwaliteit maken jouw propositie geloofwaardiger. Dat werkt beter dan algemene teksten over innovatie.
Welke recruitmentfouten vertragen het aannemen van een Data Engineer?
Een te breed functieprofiel trekt vaak de verkeerde kandidaten aan
Een te breed profiel trekt kandidaten aan die op onderdelen passen, maar niet op het echte probleem. Als je zoekt naar Python, SQL, AWS, Kubernetes, BI, machine learning en stakeholdermanagement in één rol, verlies je focus. Sterke kandidaten herkennen zo’n profiel vaak als een risico.
Schrijf daarom vanuit de opdracht. Benoem welke dataomgeving iemand aantreft, welke pipelines of platformvraagstukken spelen en waar de eerste impact ligt. Dat maakt jouw vacature scherper en geloofwaardiger.
Trage feedback kost je sterke kandidaten in een krappe arbeidsmarkt
Trage feedback kost je goede Data Engineers. Kandidaten met relevante skills voeren vaak meerdere gesprekken tegelijk en verwachten een strak proces. Als je na een technisch gesprek dagenlang stil blijft, daalt de betrokkenheid snel.
Richt je hiringproces compact in. Bepaal vooraf wie beslist, welke technische toets nodig is en wanneer feedback volgt. Snelheid mag nooit ten koste gaan van kwaliteit, maar onnodige wachttijd helpt niemand.
Een generiek interviewproces mist technische diepte
Een generiek interviewproces mist vaak de kern van data engineering. Vragen over motivatie en teamfit zijn nuttig, maar onvoldoende voor een rol met impact op architectuur en schaalbaarheid. Je hebt technische diepte nodig om de juiste keuze te maken.
Betrek daarom een Tech Lead, Data Architect of ervaren engineer bij het proces. Laat die persoon doorvragen op keuzes rond pipelines, cloud, monitoring, datakwaliteit en incidenten. Zo voorkom je een hire die op papier klopt, maar in de praktijk tekortkomt.
Waarom bepalen employer branding en retentie het succes na de hire?
Data Engineers blijven niet alleen voor een functie, maar voor technische impact
Employer branding begint bij duidelijkheid over technische impact. Data Engineers willen weten waarom hun werk ertoe doet, welke teams afhankelijk zijn van de data en welke technische ruimte ze krijgen. Een functie zonder duidelijke impact voelt snel uitvoerend.
Vertel daarom concreet wat iemand gaat verbeteren. Denk aan snellere pipelines, betrouwbaardere databeschikbaarheid, beter platformbeheer of schaalbare cloudinrichting. Dat maakt jouw verhaal sterker voor recruitment én retentie.
Onduidelijke ownership en rommelige data teams vergroten het retentierisico
Retentieproblemen ontstaan vaak door onduidelijke ownership. Als niemand eigenaar is van datakwaliteit, incidenten of architectuurkeuzes, belandt veel werk bij de Data Engineer zonder mandaat. Dat frustreert vooral senior kandidaten.
Zorg daarom dat rollen, verantwoordelijkheden en besluitvorming helder zijn. Een Data Engineer hoeft niet alles alleen op te lossen, maar moet wel weten waar invloed ligt. Dat voorkomt dat technische schuld verandert in verloop.
Hoe je vanaf de vacature al laat zien waarom jouw dataomgeving interessant is
Een sterke vacature laat de dataomgeving concreet zien. Benoem de stack, het type databronnen, de schaalvraagstukken, het team en de belangrijkste technische keuzes. Kandidaten beoordelen zo sneller of de rol past bij hun skills en ambities.
Vermijd generieke zinnen over werken met data. Schrijf liever dat iemand werkt aan betrouwbare pipelines, cloudinfrastructuur, CI/CD voor dataflows of betere observability. Dat trekt kandidaten aan die inhoudelijk willen bouwen.
FAQ
Welke skills moet een Data Engineer hebben voor big data projecten?
Een Data Engineer heeft meestal sterke skills nodig in SQL, Python of vergelijkbare talen, data pipelines, cloudplatformen zoals AWS of Azure, datamodellering, CI/CD, monitoring en datakwaliteit. Voor senior rollen telt vooral architectuurbegrip en eigenaarschap.
Wat is het verschil tussen een Data Engineer en een Data Scientist?
Een Data Engineer bouwt en beheert de infrastructuur waarmee data betrouwbaar beschikbaar komt. Een Data Scientist gebruikt die data meestal voor analyses, modellen en voorspellingen. Zonder goede data engineering werkt data science vaak minder schaalbaar.
Wanneer kies je voor een freelance Data Engineer en wanneer voor vast?
Freelance past goed bij tijdelijke projecten, migraties, specialistische platformkeuzes of piekbelasting. Vast past beter wanneer data engineering structureel onderdeel is van jouw product, platform of interne besluitvorming.
Hoe herken je een senior Data Engineer tijdens recruitment?
Een senior Data Engineer legt technische keuzes helder uit, denkt in schaalbaarheid en onderhoudbaarheid, pakt ownership over pipelines en kwaliteit, en begrijpt de impact op andere teams. Alleen jaren ervaring geven onvoldoende zekerheid.
Waarom reageren goede Data Engineers niet op onze vacature?
Vaak is het profiel te breed, de technische uitdaging te vaag, het salaris niet passend of het proces te traag. Goede Data Engineers willen snel zien welke impact, stack, autonomie en teamcontext de rol biedt.
Conclusie: een Data Engineer aannemen vraagt om scherpte vóór je gaat zoeken
Begin met het probleem dat jouw Data Engineer moet oplossen
Een Data Engineer aannemen begint niet met een lijst tools, maar met een duidelijk probleem. Wil je schaalbare pipelines bouwen, datakwaliteit verbeteren, cloudkosten beheersen of een data platform professionaliseren? Dat antwoord bepaalt welk profiel je nodig hebt.
Stem skills, salaris, proces en retentie af op de realiteit van de arbeidsmarkt
De beste hiring aanpak combineert technische scherpte met een realistische propositie. Stem skills, salaris, recruitmentproces en retentie vooraf op elkaar af. Zo voorkom je hiring mistakes en vergroot je de kans dat jouw Data Engineer ook op lange termijn waarde toevoegt.